Cloudflare disponibiliza os pesos de Clairic para extrair dados de documentos
Clairic e Clairic-flash têm repositórios publicados e uma oferta alojada em Workers AI. As interfaces e os limites precisam de ser confirmados antes de ligar documentos a um processo da empresa.
A Cloudflare anunciou em 18 de novembro de 2026 uma atualização de Clairic e o lançamento de Clairic-flash, dois modelos orientados para extrair informação. O anúncio do fornecedor indica disponibilidade em Workers AI e publicação dos pesos em Hugging Face. Os repositórios de Clairic e Clairic-flash estavam acessíveis na consulta de 21 de novembro; as duas fichas identificam a licença Apache-2.0.
O documento e a interface são partes da escolha
O anúncio inclui extração a partir de imagens e PDFs. As fichas dos repositórios documentam um auxiliar Python com entradas para texto, imagens e documentos PDF. Referem ainda um limite partilhado de quatro imagens ou páginas PDF. Isto permite identificar uma interface documentada para esses formatos; não demonstra que qualquer PDF de qualquer dimensão seja aceite.
A documentação de Clairic em Workers AI descreve documents[] para PDFs incorporados: até 4 MiB por ficheiro e um máximo conjunto de quatro páginas renderizadas e imagens. PDFs cifrados são rejeitados. O modelo continua em prévia. É suporte documentado; não testámos o endpoint.
A Cloudflare apresenta melhorias de extração e resultados de desempenho nos seus próprios ensaios. Não executámos esses ensaios nem verificámos a precisão ou a velocidade num processo empresarial. A disponibilização dos pesos e a indicação de licença nas fichas também não significam execução alojada gratuita ou dispensa de verificar as condições aplicáveis.
Análise Lyntev: começar pelos campos que têm de estar certos
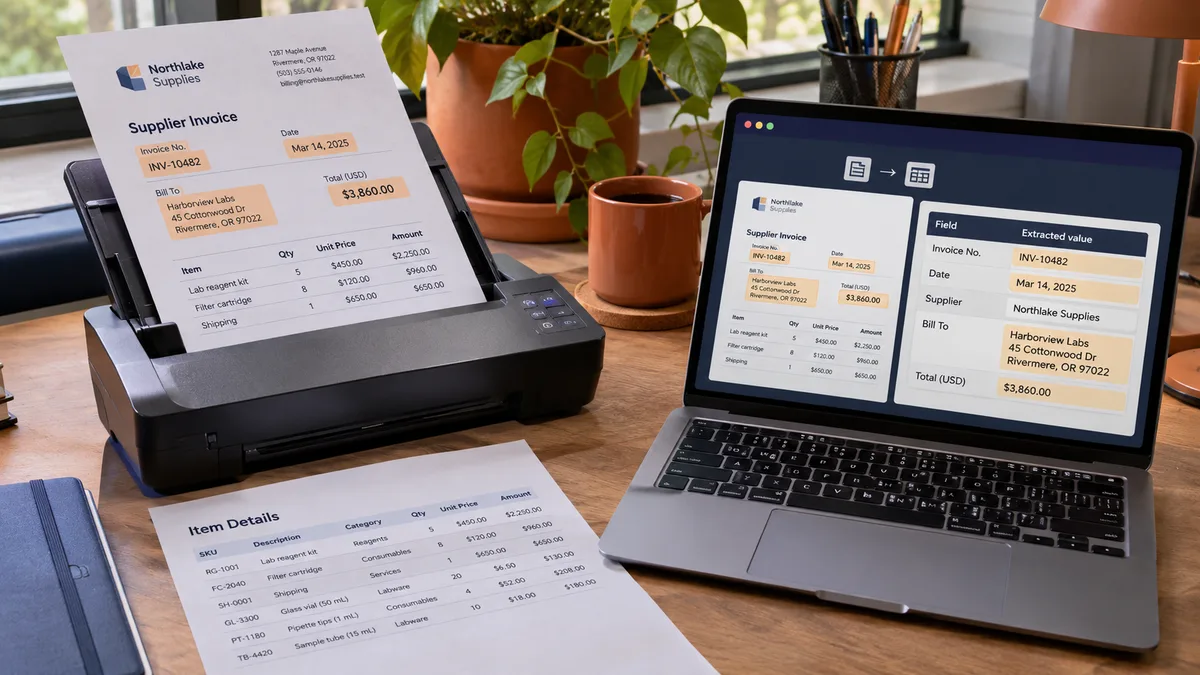
Antes de experimentar um modelo, vale a pena escrever o resultado esperado. Numa fatura fictícia, por exemplo, a equipa pode identificar fornecedor, data e total, incluindo uma versão em que falta uma dessas informações. O objetivo é observar se o resultado mantém o que consta do documento e torna a ausência visível.
Essa preparação ajuda a separar três situações: um valor lido, um valor calculado e uma estimativa. O próprio contrato dos modelos distingue tipos de resposta e apresenta indicadores de confiança. Uma empresa deve definir quais os campos que precisam de conferência e o que acontece quando a resposta está incompleta, em vez de tratar um indicador do modelo como aprovação da operação.
A decisão seguinte é sobre o processo: quem revê, onde fica o documento original e que ação pode ocorrer depois da validação. Começar com documentos fictícios permite avaliar esse percurso antes de decidir que informação empresarial pode ser enviada para a solução escolhida. É uma proposta de avaliação, não um resultado demonstrado nesta notícia.
Leituras para preparar a avaliação
- Como extrair dados de documentos com IA e conferir o resultado.
- Como testar um sistema antes de aceitar a entrega.
- Serviço comercial relacionado da Lyntev: automação de processos, para definir entradas, responsáveis e tratamento de exceções. O anúncio não comprova uma integração Lyntev com estes modelos.
Fontes e âmbito desta peça
O artigo da Cloudflare documenta o anúncio; as fichas oficiais em Hugging Face confirmam os repositórios e descrevem o auxiliar Python e a licença indicada; a documentação de Workers AI delimita a interface alojada consultada. A data do anúncio é 18 de novembro; a verificação das páginas foi feita a 21 de novembro de 2026. Não foi realizado um teste próprio dos modelos.
Fontes consultadas
- Anúncio dos modelos de extração ClairicCloudflare. Data indicada pela fonte: . Consultada: .
- Ficha oficial do modelo ClairicCloudflare em Hugging Face. Consultada: .
- Ficha oficial do modelo Clairic-flashCloudflare em Hugging Face. Consultada: .
- Documentação da interface Clairic em Workers AICloudflare. Consultada: .